Provenance wykresu i infografiki: jak wskazać autora, źródło danych i metodologię obrazu
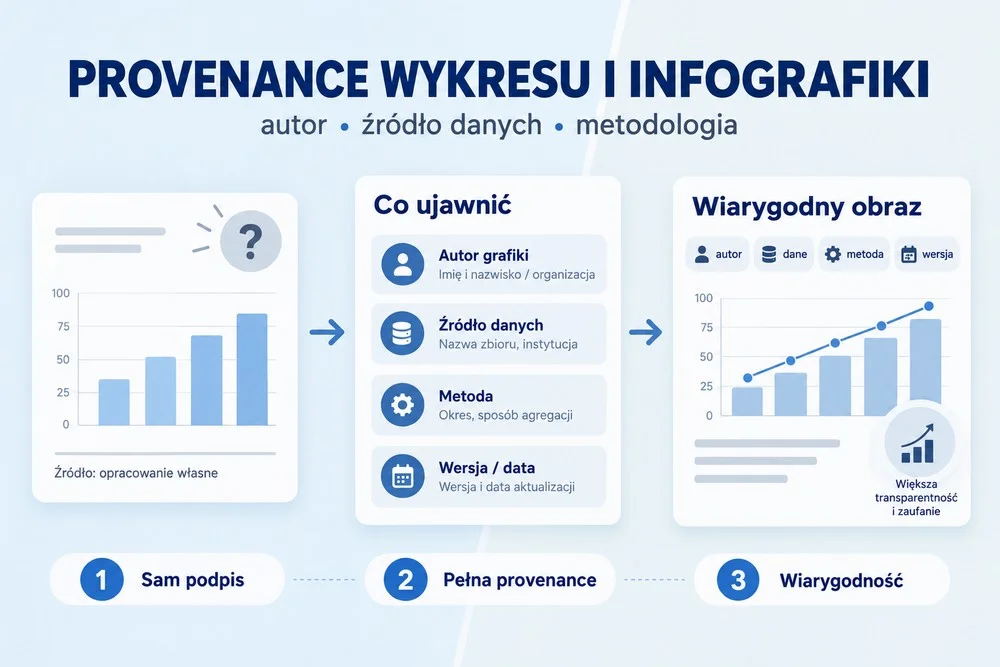
Podpis „Źródło: opracowanie własne” bywa prawdziwy, ale często mówi zbyt mało. Czytelnik nadal nie wie, kto przygotował wykres, skąd pochodzą liczby, z jakiego okresu są dane, co zostało z nimi zrobione i kiedy grafika była ostatnio aktualizowana. Przy prostym wykresie sprzedaży to niedopowiedzenie. Przy danych medycznych, finansowych, gospodarczych albo porównaniu ofert może już podważać wiarygodność całej publikacji.
Dobra provenance grafiki powinna pozwolić odtworzyć cztery rzeczy: autora obrazu, źródło danych, metodę przetworzenia oraz wersję lub datę aktualizacji. Dopiero wtedy wiadomo, czy patrzymy na oryginalną analizę, wizualizację cudzych danych, adaptację wcześniejszego materiału czy jedynie dekoracyjną infografikę. Jeśli obraz przechodzi przez system optymalizacji, przyda się też procedura sprawdzania utraty IPTC i C2PA.
„Opracowanie własne” nie wyjaśnia, z czego powstał wykres
Najczęstszy błąd redakcyjny polega na wrzuceniu kilku różnych ról do jednego worka. Grafikę mógł wykonać redaktor, dane mogły pochodzić z GUS, Eurostatu lub raportu branżowego, obliczenia przygotował analityk, a prawa do finalnego obrazu należą do wydawcy. Zdanie „opracowanie własne” nie rozróżnia żadnej z tych sytuacji.
W praktyce podpis powinien odpowiadać co najmniej na pięć pytań:
Kto stworzył obraz? Osoba, zespół redakcyjny, studio graficzne albo organizacja.
Na jakich danych oparto wykres? Potrzebna jest nazwa zbioru, publikacji lub systemu źródłowego, a nie tylko nazwa instytucji.
Jaki zakres czasu obejmują dane? „Dane GUS” bez roku lub okresu potrafią być równie nieprecyzyjne jak brak źródła.
Co zrobiono z danymi przed narysowaniem wykresu? Trzeba ujawnić agregację, filtrowanie, przeliczenia, indeksację, usuwanie braków, zaokrąglenia czy zmianę jednostek.
Kiedy zaktualizowano samą grafikę? Data publikacji artykułu i data ostatniej modyfikacji obrazu nie muszą być identyczne.
Dobry podpis nie musi mieć długości akapitu. Może wyglądać tak:
Autor grafiki: Zespół analiz redakcji. Dane: GUS, Bank Danych Lokalnych, wskazana zmienna i okres 2021–2025. Metoda: agregacja roczna, pominięcie rekordów bez wartości, zaokrąglenie do 0,1. Aktualizacja grafiki: 13.09.2026.
Taki zapis daje czytelnikowi znacznie więcej niż „opracowanie własne”, a nadal mieści się pod wykresem.
Samo wskazanie instytucji również nie wystarcza, jeśli instytucja publikuje setki serii. „Źródło: Eurostat” to za mało przy wykresie, który ma być później zweryfikowany. Minimum to nazwa datasetu lub serii, zakres czasu i informacja o ewentualnych przeliczeniach. Przy często aktualizowanych danych dobrze dodać także wersję, datę pobrania albo stan danych, np. „stan na 12.09.2026”.
Najwięcej problemów pojawia się przy automatycznie odświeżanych dashboardach. Dane mogą zmienić się w źródle, podczas gdy obraz zapisany w CMS pozostaje stary. Wtedy jedna data „aktualizacji” jest myląca. Osobno datuj dataset, osobno finalną grafikę. Jeżeli wykres został wygenerowany 10 września na podstawie zbioru z 8 września, te dwie daty opisują dwie różne rzeczy.
ImageObject porządkuje role, ale nie zastępuje poprawnego podpisu
W Schema.org obraz można opisać jako ImageObject. Dla provenance najważniejsze są pola, które rozdzielają twórcę, kredyt redakcyjny i prawa:
creator– osoba lub organizacja, która stworzyła grafikę;creditText– tekst kredytowy, czyli sposób, w jaki autor lub organizacja mają być wskazani przy publikacji;copyrightNotice– informacja o prawach, najlepiej wskazująca aktualnego właściciela praw do obrazu;contentUrl– adres konkretnego pliku obrazu;dateModified– data ostatniej modyfikacji danegoCreativeWork, a więc także obrazu opisanego jakoImageObject;isBasedOn– relacja pozwalająca wskazać zasób, z którego praca została wyprowadzona lub na którym się opiera.
Te pola nie są synonimami. To istotne zwłaszcza w redakcji korzystającej z freelancerów, agencji lub materiałów licencjonowanych. Twórca grafiki nie musi być podmiotem, który ma zostać wymieniony w linii kredytowej, a właściciel praw nie musi być samym twórcą. Właśnie dlatego wrzucenie wszędzie nazwy wydawcy jest złym skrótem.
Trzeba też odróżnić pełne możliwości Schema.org od tego, co Google dokumentuje dla metadanych obrazów. W funkcji związanej z metadanymi obrazów Google wymaga contentUrl oraz przynajmniej jednego z pól: creator, creditText, copyrightNotice albo license. Po podaniu jednego z nich pozostałe stają się rekomendowane w teście danych strukturalnych. To jednak nie oznacza, że każda właściwość dostępna w Schema.org jest wykorzystywana przez Google w ten sam sposób.
Praktyczna zasada jest prosta: najpierw modeluj dane zgodnie ze znaczeniem pól, dopiero potem optymalizuj pod konkretną funkcję wyszukiwarki. Nie zamieniaj creator na copyrightNotice tylko dlatego, że oba pola dotyczą osoby lub organizacji. Semantyka jest inna.
W przypadku zdjęć i grafik osadzonych jako pliki warto rozważyć również metadane IPTC. Standard przewiduje osobne pola dla Creator, Credit Line i Copyright Notice. To przydatne, ponieważ IPTC może być zapisane wewnątrz pliku i „podróżować” razem z obrazem, gdy jest on kopiowany do innego systemu. Dane strukturalne na stronie są natomiast przypisane do konkretnego użycia obrazu na konkretnej stronie.
Jest tu jednak drażliwy punkt: podczas optymalizacji obrazów część systemów i narzędzi usuwa metadane pliku, żeby zmniejszyć jego rozmiar. Zyskuje się kilka lub kilkadziesiąt kilobajtów, ale można przy okazji stracić informacje o twórcy i prawach. Jeśli provenance ma znaczenie redakcyjne, nie wolno zakładać, że metadane IPTC przetrwają automatyczny pipeline obrazów. Trzeba to sprawdzić po wygenerowaniu wersji WebP, AVIF lub po przepuszczeniu pliku przez CDN.
Jeżeli na stronie jednocześnie występują dane strukturalne i IPTC, należy utrzymywać je w zgodzie. Google deklaruje, że przy konflikcie między nimi dla swoich funkcji wykorzysta dane strukturalne. To nie jest powód, żeby ignorować IPTC. To powód, żeby nie prowadzić dwóch niezależnych, rozjeżdżających się źródeł prawdy.
Połącz obraz z datasetem i metodologią, a dopiero potem waliduj markup
Najbardziej użyteczny model nie kończy się na ImageObject. Wykres oparty na liczbach powinien mieć wskazany dataset, najlepiej jako osobny zasób z własną tożsamością, wersją i metodologią. Schema.org przewiduje typ Dataset, a w jego opisie można wykorzystać m.in. creator, identifier, version, temporalCoverage, variableMeasured i measurementTechnique.
To pozwala zbudować czytelny łańcuch:
wykres → źródłowy dataset → metoda pomiaru lub obliczeń → autor danych / instytucja odpowiedzialna → wersja lub okres danych.
Jeżeli grafika jest pochodną określonego zbioru, relacja isBasedOn dobrze opisuje tę zależność na poziomie Schema.org. W bardziej rozbudowanych systemach provenance można modelować jeszcze dokładniej: W3C PROV rozdziela zasób, czynność przetwarzania i podmiot odpowiedzialny. Dla typowej strony redakcyjnej pełny model PROV będzie często przesadą, ale jego logika jest trafna: sam obraz to efekt procesu, nie źródło prawdy o danych.
Najważniejsza część metodologii powinna być widoczna także dla człowieka. Nie chowaj jej wyłącznie w JSON-LD. Przy wykresie wystarczy zwykle krótki blok obejmujący:
zakres danych i datę ich stanu;
definicję analizowanej zmiennej;
filtry i wykluczenia;
sposób agregacji: suma, średnia, mediana, udział, indeks;
zmianę jednostek, walut lub wartości nominalnych na realne;
zasady obsługi braków danych;
dokładność i sposób zaokrągleń;
informację, czy wykres pokazuje wartości surowe, przeliczone czy prognozowane.
To właśnie tutaj powstają najpoważniejsze nieporozumienia. Wykres „średniej ceny” może wyglądać poprawnie, ale bez informacji, czy użyto średniej arytmetycznej, mediany czy średniej ważonej, odbiorca nie jest w stanie powtórzyć obliczenia. Podobnie „wzrost o 10%” nie mówi, czy chodzi o zmianę o 10 procent, czy o 10 punktów procentowych. Provenance ma usuwać takie niejasności, nie tylko wskazywać nazwisko pod obrazkiem.
W kontekście E-E-A-T trzeba zachować proporcje. Google wprost rozdziela pytania „kto stworzył treść” i „jak treść powstała”, a przejrzyste autorstwo i sposób przygotowania materiału wspierają wiarygodność. Nie należy jednak robić z ImageObject magicznego czynnika rankingowego. E-E-A-T nie jest pojedynczym, technicznym przełącznikiem, a poprawny markup nie gwarantuje ani wyświetlenia dodatkowych informacji w wyszukiwarce, ani wyższej pozycji.
Procedura wdrożenia powinna więc wyglądać w tej kolejności:
Ustal źródło danych i wersję lub datę stanu.
Zapisz metodę przetwarzania danych w formie zrozumiałej dla czytelnika.
Rozdziel autora grafiki, tekst kredytowy i właściciela praw.
Dodaj dane strukturalne
ImageObjectoraz, gdy ma to sens, opisDataset.Sprawdź wynikowy kod strony po renderowaniu przez CMS, a nie tylko szablon przed publikacją.
Zweryfikuj dane strukturalne w Rich Results Test i sprawdź stronę w URL Inspection po wdrożeniu.
Jeśli używasz IPTC, pobierz finalny plik z produkcyjnego CDN i sprawdź, czy metadane nie zostały usunięte.
To ostatnie jest częstym miejscem awarii. CMS zapisuje poprawny oryginał, ale CDN generuje nową wersję i usuwa metadane. Bez sprawdzenia pliku z produkcyjnego adresu można mieć poprawny proces „na papierze” i niepoprawny rezultat.
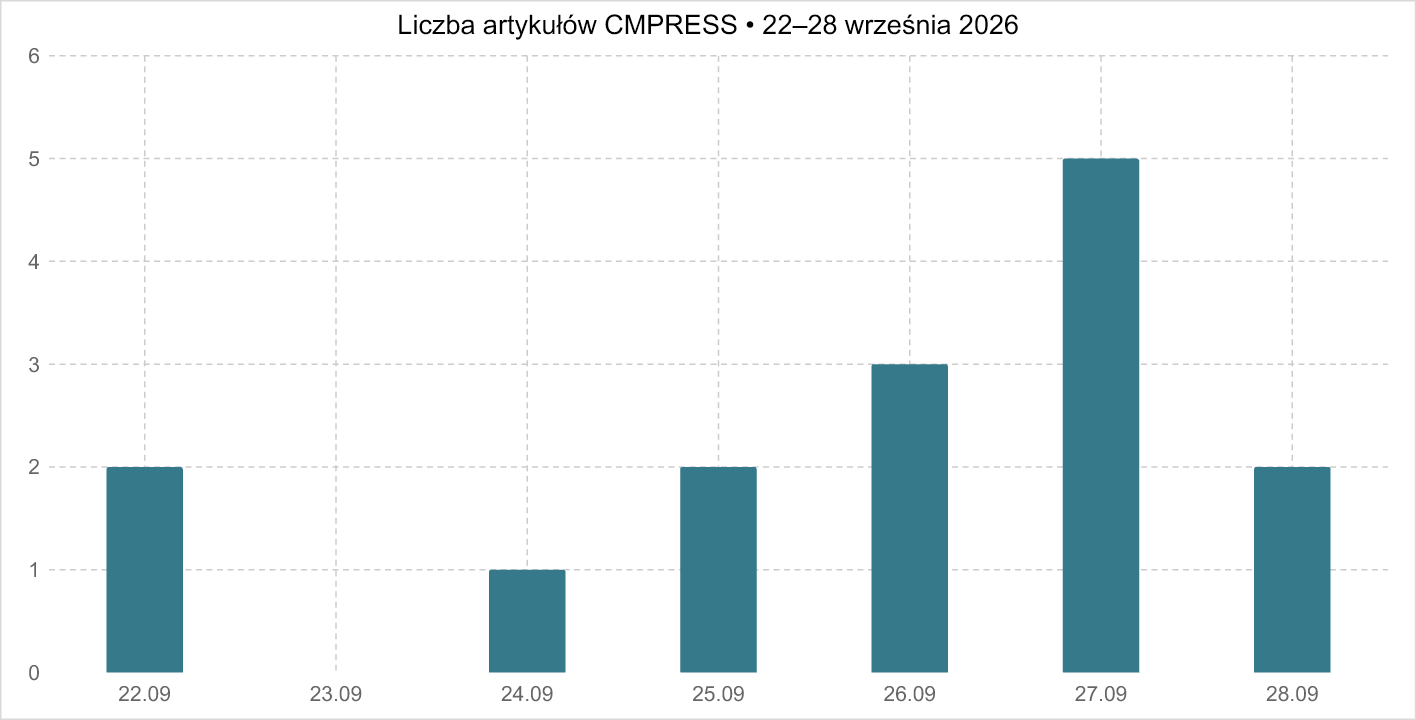
Rzeczywisty wykres: daty publikacji 15 artykułów CMPRESS
Przykład powstał z publicznej listy artykułów CMPRESS i jej drugiej strony, odczytanych 28.09.2026. Pokazuje liczbę unikalnych artykułów przypisanych do widocznych dat publikacji. To migawka biblioteki, a nie dane o ruchu, skuteczności SEO ani historii pierwszego pojawienia się stron w internecie.
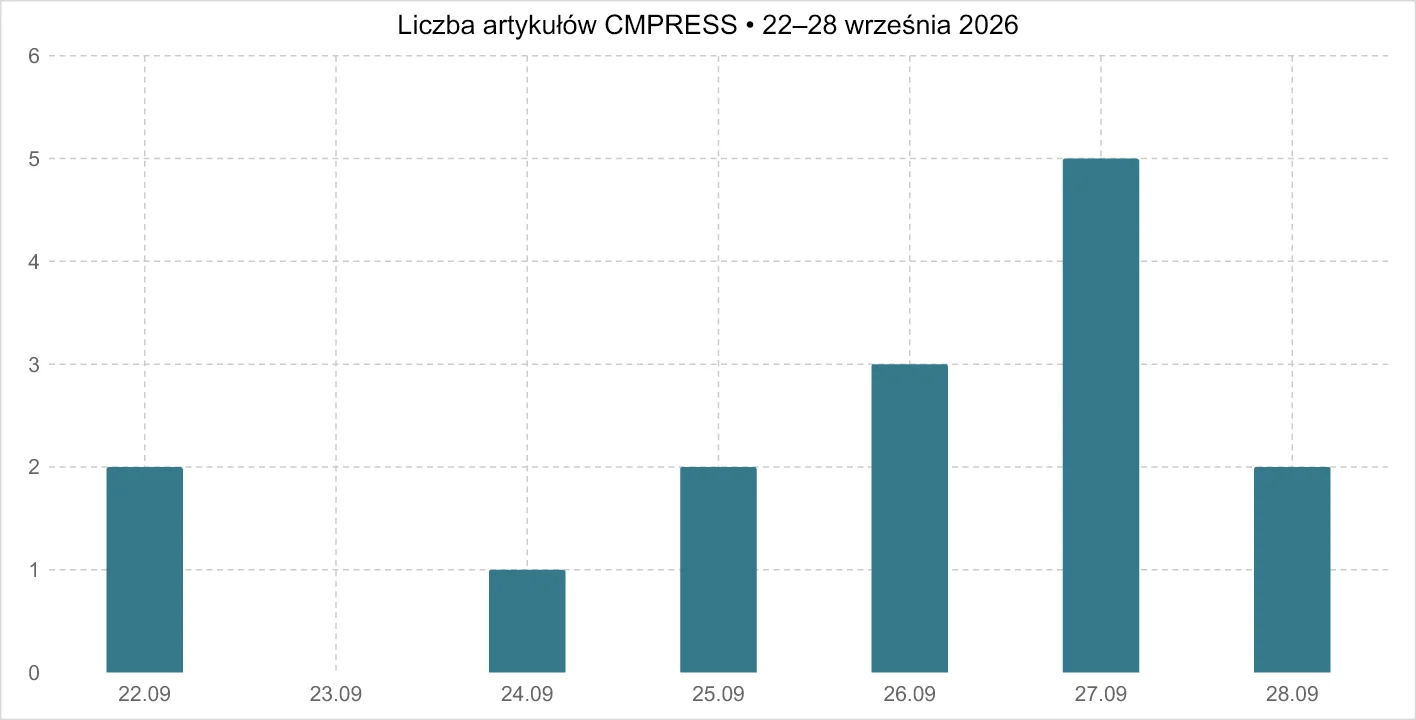
Pobierz dane zagregowane CSV lub oryginalny wykres PNG. Wykres PNG jest udostępniony bezpośrednio w CMPRESS; plik CSV pozostaje dostępny w serwisie Gotujemy coś należącym do tej samej sieci.
| Data publikacji | Liczba artykułów |
|---|---|
| 22.09.2026 | 2 |
| 23.09.2026 | 0 |
| 24.09.2026 | 1 |
| 25.09.2026 | 2 |
| 26.09.2026 | 3 |
| 27.09.2026 | 5 |
| 28.09.2026 | 2 |
| Łącznie | 15 |
Rekordy źródłowe pozwalające odtworzyć obliczenie
Jak odtworzyć wynik: otwórz obie strony biblioteki, spisz każdą kartę tylko raz według adresu artykułu i zgrupuj rekordy po dacie. W zakresie 22–28 września uwzględnij również 23 września z zerową liczbą rekordów. Wyklucz strony stałe, szkice i zaplanowane wpisy niewidoczne w bibliotece. Późniejszy odczyt może dać inne wyniki, ponieważ redakcja może zmienić daty lub dodać artykuły. Dlatego zachowano tu tabelę obserwacji z dnia pomiaru.
FAQ
Czy podpis „Źródło: opracowanie własne” jest błędem?
Nie, jeśli rzeczywiście oznacza autorskie opracowanie i obok wskazano, na jakich danych je wykonano. Samodzielna wizualizacja cudzych danych nadal wymaga podania źródła tych danych.
Czy creator może wskazywać organizację zamiast osoby?
Tak. Schema.org i dokumentacja Google dopuszczają Person lub Organization. Nie należy jednak automatycznie wpisywać nazwy wydawcy, jeśli faktycznym twórcą była konkretna osoba i redakcja chce zachować precyzyjne autorstwo.
Czy copyrightNotice zastępuje creator?
Nie. creator opisuje twórcę, a copyrightNotice dotyczy informacji o prawach i powinien wskazywać aktualnego właściciela praw. Te role mogą należeć do różnych podmiotów.
Gdzie zapisać datę aktualizacji wykresu?
Najlepiej w widocznym podpisie lub sekcji metodologicznej oraz w dateModified dla samego obrazu. Daty datasetu i grafiki trzeba prowadzić oddzielnie, jeśli dane są aktualizowane w innym terminie niż wizualizacja.
Czy wystarczy podać nazwę instytucji, np. „GUS”?
Nie przy materiale, który ma być możliwy do sprawdzenia. Trzeba dopisać nazwę zbioru lub serii, okres, wersję albo datę stanu oraz najważniejsze przekształcenia wykonane przed narysowaniem wykresu.
Czy dane strukturalne gwarantują lepszą widoczność w Google?
Nie. Poprawny markup pomaga systemom zrozumieć treść i może kwalifikować stronę do określonych funkcji, ale Google nie gwarantuje ich wyświetlenia. Samo dodanie ImageObject nie zastąpi czytelnego źródła i metodologii.
Pierwszą rzeczą do poprawienia nie jest JSON-LD. Najpierw usuń z publikacji takie podpisy „opracowanie własne”, przy których nie da się wskazać konkretnego datasetu, okresu danych i sposobu obliczeń. Dopiero gdy ten łańcuch jest kompletny, przenoś go do ImageObject, Dataset i metadanych IPTC. Markup może uporządkować provenance, ale nie naprawi brakującego źródła.
Przejdź do części artykułu
Opublikowane w kategorii: Badania, raporty i treści eksperckie