Autor to encja, nie podpis pod artykułem: jak zbudować graf autora dla SEO i AI
Samo "author": "Jan Kowalski" rozwiązuje tylko jeden problem: przekazuje nazwę. Nie odpowiada jednak na znacznie ważniejsze pytanie — kim dokładnie jest Jan Kowalski i czy Jan Kowalski z tego artykułu jest tą samą osobą, która ma profil autorski w serwisie, pracuje dla wskazanej redakcji i występuje pod tym nazwiskiem w innych wiarygodnych miejscach.
To właśnie tutaj kończy się myślenie o autorze jako podpisie, a zaczyna modelowanie autora jako encji.
Dla Google różnica jest praktyczna. W dokumentacji danych strukturalnych Article Google zdecydowanie zaleca określenie typu autora oraz podanie url albo sameAs, aby łatwiej było rozróżnić autorów. Gdy url prowadzi do wewnętrznego profilu autora, Google rekomenduje oznaczenie takiej strony jako ProfilePage.
Nie oznacza to jednak, że dodanie rozbudowanego JSON-LD automatycznie podniesie pozycje albo zagwarantuje obecność materiału w AI Overviews czy AI Mode. Nie istnieje specjalny schema markup dla generatywnego AI w Google Search. Google wprost wskazuje, że dla funkcji AI obowiązują przede wszystkim zwykłe fundamenty SEO, indeksowalność, jakość treści i zgodność danych strukturalnych z treścią widoczną na stronie.
Graf autora ma więc inne zadanie: usunąć niejednoznaczność i opisać relacje między artykułem, człowiekiem, jego profilem oraz organizacją w sposób możliwy do przetworzenia maszynowego.
Samo author.name identyfikuje napis, a nie człowieka
Najczęstszy wariant implementacji wygląda niewinnie:
{
  "@type": "Article",
  "author": {
    "@type": "Person",
    "name": "Jan Kowalski"
  }
}
Nie jest to błędny kod. Jest po prostu ubogi.
Person z samym polem name mówi: „autorem jest osoba o nazwie Jan Kowalski”. Nie dostarcza natomiast mocnego identyfikatora pozwalającego powiązać tę osobę z innymi wystąpieniami tej samej encji.
Problem szczególnie dobrze widać, gdy dwóch ekspertów nosi to samo nazwisko. W redakcji mogą pracować dwie Anny Nowak. Autor może zmienić stanowisko. Ten sam ekspert może publikować w kilku serwisach. Profil może istnieć pod innym adresem niż strona artykułu. Sam ciąg znaków w name tych przypadków nie rozwiązuje.
Dlatego rozsądne minimum dla autora będącego osobą wygląda raczej tak:
{
  "@type": "Person",
  "name": "Jan Kowalski",
  "url": "https://example.pl/autorzy/jan-kowalski"
}
url powinien identyfikować autora, a nie prowadzić przypadkowo do strony głównej firmy, kategorii wszystkich autorów czy wyników wyszukiwania w serwisie.
Jeżeli witryna ma własne profile autorów, najlepszym kandydatem jest zwykle właśnie trwały adres takiego profilu. Google podaje stronę biograficzną, stronę „about me” czy profil autora jako przykłady adresów pozwalających jednoznaczniej określić tożsamość.
Drugi element to sameAs. W Schema.org oznacza on URL strony referencyjnej jednoznacznie wskazującej tę samą encję.
W przypadku autora mogą to być na przykład:
zweryfikowany profil zawodowy należący do tej osoby,
oficjalna strona osobista,
profil w instytucji, w której dana osoba rzeczywiście występuje,
jednoznaczny identyfikator w zewnętrznej bazie wiedzy.
Tu pojawia się jeden z częstszych błędów implementacyjnych: sameAs nie oznacza „jest związany z”.
Nie należy robić czegoś takiego:
{
  "@type": "Person",
  "name": "Jan Kowalski",
  "sameAs": "https://example.pl/firma"
}
jeżeli example.pl/firma opisuje pracodawcę Jana Kowalskiego. Człowiek i firma nie są tą samą encją.
Do relacji zawodowej służy między innymi worksFor, a w innych sytuacjach odpowiednie może być affiliation. Jeżeli artykuł publikuje konkretna redakcja lub firma, jej relację z materiałem można dodatkowo wyrazić przez publisher.
To pozornie drobna różnica, ale właśnie ona oddziela graf wiedzy od zbioru przypadkowych adresów URL.
Trzeba też pilnować autorów wieloosobowych. Jeżeli artykuł ma dwóch autorów widocznych na stronie, w danych strukturalnych powinny występować dwie osobne encje autora. Nie należy tworzyć jednego:
"name": "Anna Nowak, Piotr Wiśniewski"
To dwie osoby, więc powinny być dwoma obiektami Person.
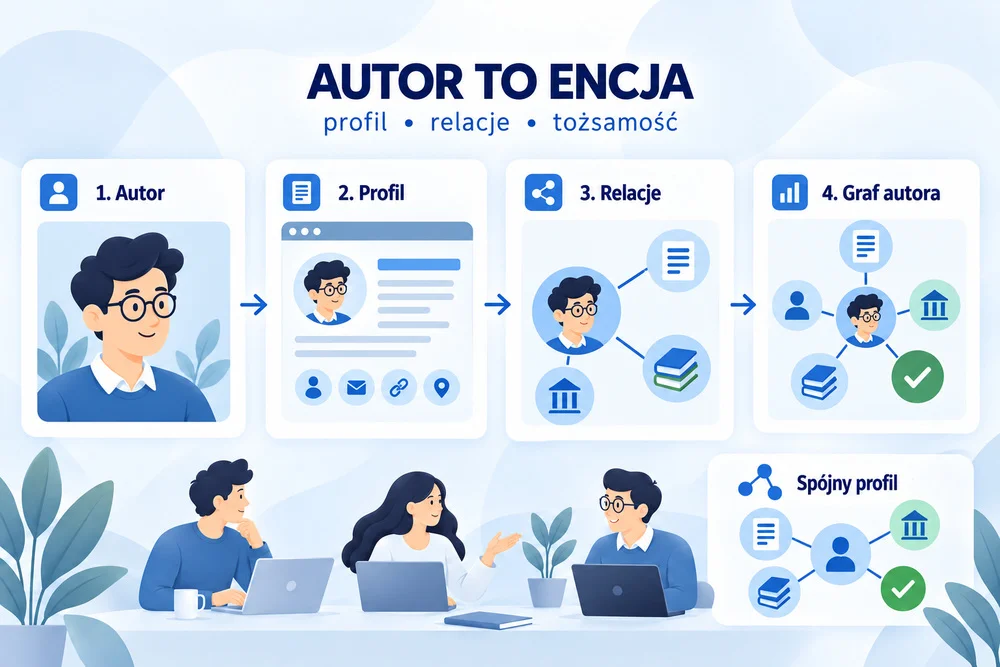
Article, Person, ProfilePage i Organization to osobne węzły połączone konkretnymi relacjami
Hasło „Article → Person → ProfilePage → sameAs → Organization” dobrze pokazuje potrzebę budowy grafu, ale nie powinno być traktowane jako dosłowny łańcuch właściwości.
Poprawny model jest bardziej precyzyjny.
Article → Person
Artykuł wskazuje autora przez author.
Article
└── author → Person
Person ↔ ProfilePage
Strona profilu opisuje osobę. W ProfilePage podstawową encją jest więc mainEntity: Person.
Z drugiej strony Person może wskazywać stronę, która tę osobę opisuje, przez mainEntityOfPage. Dodatkowo profil autora może być adresem użytym w url.
ProfilePage
└── mainEntity → Person

Person
├── url → adres profilu
└── mainEntityOfPage → ProfilePage
Nie trzeba sztucznie mnożyć tych relacji w każdej implementacji. Jeżeli jednak budujemy jeden spójny @graph, jednoznaczne wskazanie obu węzłów przez @id pozwala uniknąć powielania całego obiektu Person.
Person → zewnętrzne potwierdzenia tożsamości
Do tego służy sameAs.
Person
└── sameAs → zewnętrzny profil tej samej osoby
sameAs należy traktować restrykcyjnie. Nie jest miejscem na każdy link dotyczący autora. Strona konferencji, na której ktoś kiedyś występował, artykuł cytujący autora czy profil pracodawcy nie stają się przez to tą samą encją.
Person → Organization
Relację człowieka z organizacją można zapisać jako:
Person
└── worksFor → Organization
Jeżeli człowiek jest związany z organizacją, ale nie jest jej pracownikiem, można rozważyć affiliation. Nie powinno się używać worksFor tylko dlatego, że autor jednorazowo napisał tekst dla danej marki.
Article → Organization
Niezależnie od relacji zawodowej autora sam artykuł może wskazywać wydawcę:
Article
└── publisher → Organization
To ważne rozróżnienie. Autor i wydawca pełnią dwie różne role. Google wyraźnie oddziela author od publisher i nie zaleca dopisywania wydawcy do author.name.
W większych serwisach właśnie tutaj powstaje bałagan. Jeden moduł CMS generuje autora, inny dodaje organizację, wtyczka SEO dokłada kolejny obiekt Person, a szablon profilu tworzy trzecią wersję tej samej osoby. Efektem mogą być trzy węzły opisujące Jana Kowalskiego, ale bez wspólnego identyfikatora.
Rozwiązaniem jest stabilne @id.
Przykładowo:
https://example.pl/autorzy/jan-kowalski#person
może być identyfikatorem encji osoby, natomiast:
https://example.pl/autorzy/jan-kowalski#profile
identyfikatorem dokumentu ProfilePage.
@id w JSON-LD pozwala odwoływać się do tego samego węzła z różnych miejsc grafu bez ponownego definiowania całej osoby. Sam fragment #person nie musi być osobną stroną dostępną dla użytkownika. Kluczowe jest natomiast zachowanie identyfikatora konsekwentnie w obrębie modelu.
Najgorsza praktyka to generowanie innego identyfikatora autora w każdym artykule. Jeżeli ta sama Anna Nowak ma w pięćdziesięciu publikacjach pięćdziesiąt niezależnych węzłów bez wspólnego odniesienia, tracimy dużą część zalety modelowania encji.
Kompletny graf JSON-LD autora: wzorzec do wdrożenia, a nie kopiowania 1:1
Poniższy kod jest przykładem edukacyjnym z całkowicie fikcyjnymi danymi. Adresy w domenach przykładowych nie opisują rzeczywistych osób ani firm. Przed wdrożeniem trzeba podstawić prawdziwe URL-e, daty, nazwę organizacji i dane autora, które są również widoczne lub możliwe do zweryfikowania w serwisie.
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Article",
      "@id": "https://example.pl/poradniki/audyt-techniczny#article",
      "url": "https://example.pl/poradniki/audyt-techniczny",
      "headline": "Jak przeprowadzić audyt techniczny serwisu",
      "datePublished": "2026-09-20T09:00:00+02:00",
      "dateModified": "2026-09-24T16:30:00+02:00",
      "author": {
        "@id": "https://example.pl/autorzy/anna-nowak#person"
      },
      "publisher": {
        "@id": "https://example.pl/#organization"
      }
    },
    {
      "@type": "Person",
      "@id": "https://example.pl/autorzy/anna-nowak#person",
      "name": "Anna Nowak",
      "jobTitle": "Redaktorka technologiczna",
      "url": "https://example.pl/autorzy/anna-nowak",
      "mainEntityOfPage": {
        "@id": "https://example.pl/autorzy/anna-nowak#profile"
      },
      "sameAs": [
        "https://www.linkedin.com/in/anna-nowak-przyklad",
        "https://example.org/anna-nowak-id"
      ],
      "worksFor": {
        "@id": "https://example.pl/#organization"
      }
    },
    {
      "@type": "ProfilePage",
      "@id": "https://example.pl/autorzy/anna-nowak#profile",
      "url": "https://example.pl/autorzy/anna-nowak",
      "mainEntity": {
        "@id": "https://example.pl/autorzy/anna-nowak#person"
      },
      "dateModified": "2026-09-24T16:00:00+02:00"
    },
    {
      "@type": "Organization",
      "@id": "https://example.pl/#organization",
      "name": "Example Media Polska",
      "url": "https://example.pl/"
    }
  ]
}
Najważniejszą częścią tego przykładu nie jest liczba właściwości. Jest nią spójność identyfikatorów.
Artykuł nie tworzy własnej kopii Anny Nowak. Odwołuje się do:
"author": {
  "@id": "https://example.pl/autorzy/anna-nowak#person"
}
A dokładnie ten sam @id występuje w obiekcie Person.
ProfilePage również nie definiuje drugiej Anny Nowak. Wskazuje istniejącą encję:
"mainEntity": {
  "@id": "https://example.pl/autorzy/anna-nowak#person"
}
Organizacja działa identycznie. worksFor osoby i publisher artykułu odwołują się do jednego węzła:
https://example.pl/#organization
To daje graf:
Article
├── author ──────────────→ Person
│                          ├── url ─────────────→ strona profilu
│                          ├── mainEntityOfPage → ProfilePage
│                          ├── sameAs ──────────→ zewnętrzne identyfikatory osoby
│                          └── worksFor ────────→ Organization
│
└── publisher ─────────────────────────────────→ Organization

ProfilePage
└── mainEntity ──────────→ Person
I właśnie taki schemat lepiej oddaje sens architektury niż uproszczone „Article → Person → ProfilePage → sameAs → Organization”.
Szczególnie ważne jest ostatnie rozróżnienie: organizacja nie powinna znaleźć się w sameAs osoby, chyba że z jakiegoś niezwykłego powodu adres wskazuje faktycznie tę samą osobę, a nie przedsiębiorstwo.
Przed publikacją sprawdziłbym implementację w tej kolejności:
Tożsamość autora. Czy każdy artykuł rzeczywiście wskazuje tę samą encję
Person, gdy autorem jest ta sama osoba?Stronę profilową. Czy URL autora zwraca kod 200, jest indeksowalny i faktycznie opisuje jedną osobę?
Relację
ProfilePage.mainEntity. Czy profil wskazuje właściwą osobę?sameAs. Czy każdy adres identyfikuje dokładnie tę samą osobę? Linki wątpliwe lepiej usunąć niż dodawać „dla mocy”.Organizację. Czy
worksFor,affiliationipublisheropisują rzeczywiste, różne relacje?Zgodność z treścią widoczną. Dane strukturalne nie powinny przedstawiać stanowiska, biografii czy afiliacji, których strona w żaden sposób nie potwierdza.
Daty.
dateModifiedartykułu powinno dotyczyć modyfikacji artykułu.dateModifiedprofilu autora nie powinno zmieniać się tylko dlatego, że autor opublikował kolejny tekst; Google sugeruje, by odnosiło się do zmian metadanych samego profilu.Walidację. Najpierw poprawność JSON-LD, później test danych strukturalnych i kontrola strony tak, jak widzi ją Google.
Nie zaczynałbym od masowego dokładania profili LinkedIn, Wikidata czy innych sameAs. To częsty odruch i zły priorytet. Jeśli witryna ma 500 artykułów, a autor raz występuje jako Person, raz jako zwykły tekst, raz pod trzema różnymi @id, to właśnie normalizacja wewnętrznej encji autora daje najpierw porządek potrzebny do dalszego modelowania.
Dopiero potem warto rozszerzać graf.
Dla systemów AI obowiązuje dodatkowo ważne ograniczenie: taki kod nie jest przepustką do odpowiedzi generatywnych. Google nie wymaga specjalnych danych Schema.org dla AI Overviews ani AI Mode i ostrzega przed nadmiernym koncentrowaniem się na structured data jako sposobie „optymalizacji pod AI”. Strona nadal musi być dostępna dla crawlera, indeksowalna, przydatna i zgodna z treścią rzeczywiście przedstawioną użytkownikowi.
Graf autora warto więc budować nie jako sztuczkę GEO, lecz jako techniczną warstwę spójnej identyfikacji encji, która ma sens również poza pojedynczym wynikiem wyszukiwania.
Jak graf autora działa na CMPRESS
W publicznym kodzie CMPRESS sprawdzonym 28.09.2026 profil Sebastiana Milera jest opisany jako ProfilePage. Jego mainEntity i pole author tego artykułu wskazują ten sam identyfikator: https://cmpress.pl/#sebastian-miler. Wydawca ma odrębny identyfikator https://cmpress.pl/#publisher.
Poniżej zestawiono istotne pola z dwóch rzeczywistych stron w jeden skrócony graf porównawczy. To wyciąg ułatwiający kontrolę, nie pełna kopia wszystkich danych strony.
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "ProfilePage",
      "@id": "https://cmpress.pl/o-autorze/#profile",
      "mainEntity": {
        "@type": "Person",
        "@id": "https://cmpress.pl/#sebastian-miler",
        "name": "Sebastian Miler",
        "url": "https://cmpress.pl/o-autorze/"
      }
    },
    {
      "@type": "Article",
      "@id": "https://cmpress.pl/artykuly/autor-to-encja-nie-podpis-pod-artykulem-jak-zbudowac-graf-autora-dla-seo-i-ai/#article",
      "author": {
        "@id": "https://cmpress.pl/#sebastian-miler"
      },
      "publisher": {
        "@id": "https://cmpress.pl/#publisher",
        "@type": "Organization",
        "name": "PageSEO – Miler Sebastian"
      }
    }
  ]
}
Co potwierdza ten przykład? Profil i artykuł są zgodne co do identyfikatora autora, jego nazwiska i adresu profilu. Nie jest to dowód, że Google połączył encję w swoim grafie ani że wystąpiła zmiana pozycji. Wdrożenie można skontrolować, otwierając kod obu stron i porównując dokładne ciągi @id.
Jeżeli w redakcji pojawi się drugi Sebastian Miler, potrzebuje własnego identyfikatora i profilu. Nie dopisujemy obu osób do istniejącego węzła. Sposób rozróżnienia opisuje poradnik o dwóch ekspertach o tym samym nazwisku.
FAQ: graf autora w praktyce
Czy samo author.name jest błędem?
Nie. Jest poprawnym, ale bardzo ograniczonym opisem autora. Jeżeli masz własną stronę autora, rozsądniejszym modelem jest Person z nazwą i trwałym url, a następnie konsekwentne odwoływanie się do tej samej osoby.
Czy każdy autor musi mieć ProfilePage?
Nie. Google nie wymaga ProfilePage dla każdego artykułu. Jeżeli jednak author.url prowadzi do wewnętrznej strony profilowej, Google rekomenduje oznaczenie autora na tej stronie za pomocą danych strukturalnych ProfilePage.
Czy sameAs powinno prowadzić do strony pracodawcy?
Nie, jeśli pracodawca jest inną encją. sameAs oznacza tę samą rzecz lub osobę. Relację pracownik–organizacja opisuje się przykładowo przez worksFor, a luźniejsze powiązanie organizacyjne może być opisane przez affiliation.
Czy profil autora i osoba powinny mieć ten sam @id?
Nie. Osoba jest Person, a dokument prezentujący jej profil jest ProfilePage. Mogą mieć osobne @id, połączone przez mainEntity i mainEntityOfPage.
Czy warto dodawać sameAs do każdego serwisu społecznościowego autora?
Nie. Lepiej podać dwa jednoznaczne, prawdziwe odniesienia niż dziesięć profili o niepewnej tożsamości. Każdy URL powinien faktycznie identyfikować tę samą osobę.
Czy @graph jest obowiązkowy?
Nie. JSON-LD można zapisać także jako zagnieżdżone obiekty. @graph staje się szczególnie wygodny, gdy na stronie występuje kilka współdzielonych encji — na przykład Article, Person, ProfilePage i Organization — które chcemy łączyć za pomocą stabilnych @id.
Czy taki graf poprawi widoczność w AI Overviews lub AI Mode?
Nie ma takiej gwarancji. Google nie wymaga specjalnego Schema.org dla swoich funkcji generatywnych. Dane strukturalne powinny przede wszystkim prawidłowo opisywać treść i encje; indeksacja, wyświetlenie w wyszukiwarce i wykorzystanie w funkcjach AI nie są gwarantowane.
Od czego zacząć, jeśli serwis ma już setki artykułów?
Najpierw sprawdź jednego autora występującego w wielu publikacjach. Jeżeli w kodzie jest tworzony jako kilka różnych obiektów, ma zmienne URL-e albo nie ma stabilnego @id, usuń ten błąd przed dodawaniem kolejnych właściwości. Ustal jeden kanoniczny profil autora, jeden identyfikator encji Person i podłącz do niego artykuły. Dopiero gdy ten fundament jest spójny, dodawaj ProfilePage, sameAs oraz relacje z organizacją.
Przejdź do części artykułu
Opublikowane w kategorii: SEO techniczne