Lighthouse Agentic Browsing: pierwszy techniczny audyt strony „dla agentów”
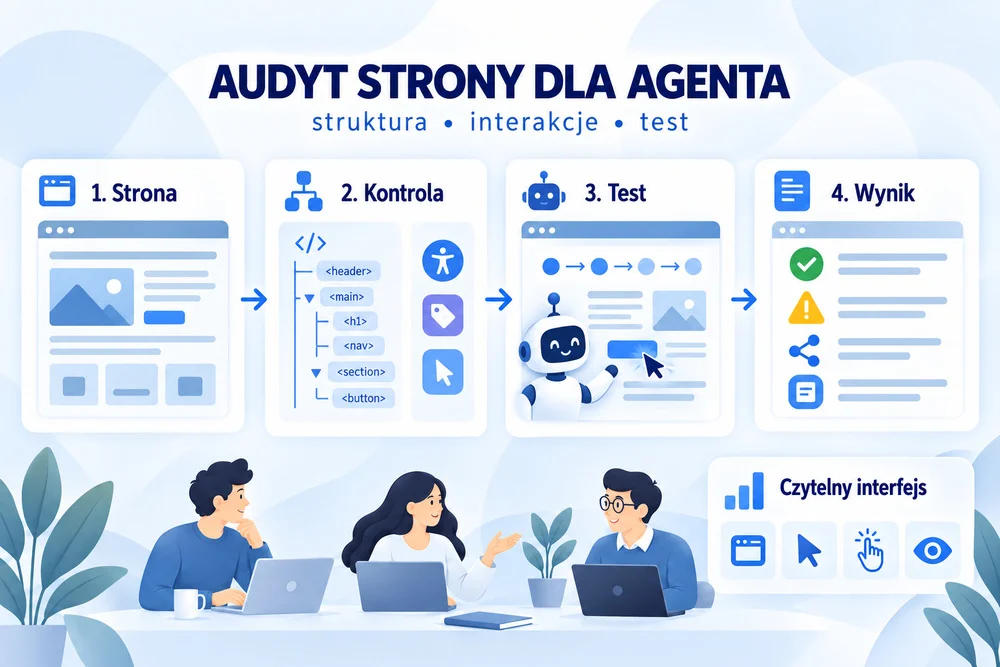
Jeżeli po otwarciu Lighthouse zobaczysz kategorię Agentic Browsing, nie traktuj jej jak kolejnego wyniku SEO. To eksperymentalny zestaw kontroli sprawdzających, czy strona ma strukturę, z którą agent AI może się technicznie dogadać: rozpoznać przyciski i formularze, znaleźć elementy w drzewie dostępności, działać na stabilnym interfejsie, odczytać llms.txt oraz — jeśli witryna korzysta z WebMCP — zrozumieć wystawione narzędzia.
Najważniejsza różnica względem klasycznych kategorii Lighthouse jest konkretna: Agentic Browsing nie ma oceny 0–100. Raport pokazuje przede wszystkim wynik ułamkowy, statusy poszczególnych kontroli oraz informacje diagnostyczne. To istotne, bo już samo przeliczenie raportu na „72 punkty gotowości na AI” byłoby nadinterpretacją.
Kategoria jest dostępna do testowania od Chrome 150, ale Google nadal opisuje ją oraz WebMCP jako rozwiązania eksperymentalne oparte na proponowanych standardach. Do tego zestaw kontroli zmienia się wraz z Lighthouse. W konfiguracji Lighthouse 13.4.1 znajduje się sześć pozycji związanych z Agentic Browsing, natomiast wydany 18 września 2026 r. Lighthouse 13.5.0 dodał kolejny audyt dotyczący Agent Resource Discovery (ARD); ta wersja ma trafić do DevTools w Chrome 156. Dlatego przy porównywaniu dwóch raportów trzeba najpierw sprawdzić wersję Lighthouse, a dopiero potem liczbę zaliczonych testów.
Co Lighthouse rzeczywiście sprawdza, a czego z raportu nie da się wywnioskować
W konfiguracji Lighthouse 13.4.1 kategoria Agentic Browsing składa się z sześciu obszarów audytowych:
agent-accessibility-tree — poprawność struktury dostępności wykorzystywanej przez agentów;
webmcp-form-coverage — pokrycie formularzy deklaracjami WebMCP;
webmcp-registered-tools — narzędzia WebMCP widoczne podczas audytu;
webmcp-schema-validity — poprawność ich schematów;
Cumulative Layout Shift (CLS) — stabilność układu;
llms.txt — pobranie i podstawowa walidacja pliku w katalogu głównym domeny.
To dobry punkt wyjścia do audytu technicznego, ale zakres jest węższy, niż sugeruje hasło „strona gotowa na agentów”. Lighthouse nie uruchamia kompletnego scenariusza typu: „wyszukaj produkt, dodaj go do koszyka, wybierz paczkomat, zaakceptuj regulamin i zamów”. Poszczególne kontrole są deterministycznymi sygnałami technicznymi, a nie pełnym testem skuteczności konkretnego modelu AI.
Nie bada też całej warstwy biznesowej. Poprawny wynik WebMCP nie oznacza, że agent ma prawo wykonać operację, że serwer prawidłowo kontroluje uprawnienia albo że proces przetwarzania danych spełnia wymagania RODO. Autoryzacja, walidacja po stronie serwera, mechanizmy anty-CSRF, zgody użytkownika i potwierdzenia operacji o skutkach finansowych nadal muszą działać niezależnie od warstwy agentowej.
Tak samo nie jest to nowy ranking SEO. Google nie dokumentuje Agentic Browsing jako czynnika pozycji w wynikach wyszukiwania. Szczególnie łatwo pomylić te dwa światy przy llms.txt, ponieważ Lighthouse kontroluje taki plik, a Google Search jednocześnie jednoznacznie informuje, że go nie wykorzystuje do poprawiania widoczności ani pozycji. Sam fakt pojawienia się testu w Lighthouse nie oznacza więc automatycznie sygnału rankingowego.
Pierwszy audyt warto wykonać według prostej procedury:
Zanotuj wersję Chrome i Lighthouse. Bez tego późniejsze porównanie raportów jest mało wiarygodne.
Testuj reprezentatywny stan strony — osobno stronę główną, kluczowy formularz, kartę produktu, koszyk czy aplikację po zalogowaniu, jeśli właśnie tam agent miałby działać.
Przy stronach z dynamiczną reklamą, CMP, widgetem czatu albo ciężkim SPA nie opieraj decyzji na jednym przebiegu. Powtórz test i sprawdź, czy nie zmienia się DOM lub moment rejestracji narzędzi.
Nie naprawiaj pozycji w raporcie według kolejności, w jakiej je wyświetlono. Najpierw accessibility tree i stabilność interfejsu, potem dodatkowe warstwy takie jak
llms.txtczy WebMCP.
Ta kolejność ma praktyczne uzasadnienie: semantyczny HTML, prawidłowe etykiety i stabilny layout pomagają nie tylko agentom, ale także użytkownikom i technologiom asystującym. WebMCP jest natomiast inwestycją specyficzną dla rozwijającego się ekosystemu agentowego.
Accessibility tree i CLS: dwa problemy, które istnieją niezależnie od mody na agentów
Najbardziej dojrzała część Agentic Browsing nie dotyczy nowych plików ani protokołów. Dotyczy rzeczy, które strony powinny robić poprawnie od dawna.
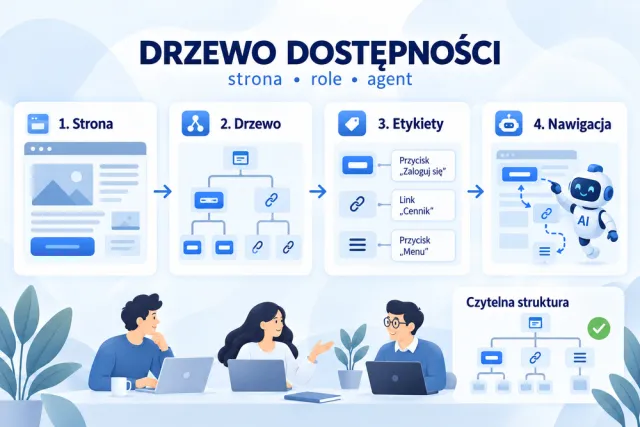
Accessibility tree jest maszynową reprezentacją interfejsu tworzoną przez przeglądarkę na podstawie HTML, semantyki i ARIA. Agent może dzięki niej otrzymać informację, że dany element jest przyciskiem o nazwie „Dodaj do koszyka”, polem formularza „Adres e-mail” albo linkiem „Regulamin”, zamiast analizować wyłącznie piksele na ekranie.
Lighthouse koncentruje się tu między innymi na trzech grupach problemów:
nazwach i etykietach elementów interaktywnych — przycisk bez programowej nazwy jest problemem zarówno dla czytnika ekranu, jak i agenta;
integralności struktury ARIA — role, wymagane atrybuty oraz relacje rodzic–dziecko muszą być logiczne;
widoczności w accessibility tree — element nie powinien być jednocześnie interaktywny i ukryty przed warstwą dostępności.
Typowy błąd wygląda banalnie:
<button>
  <svg>...</svg>
</button>
Człowiek widzi ikonę koszyka. Maszyna może dostać przycisk bez sensownej nazwy. Poprawka nie polega na „optymalizacji pod AI”, lecz na nadaniu kontrolce jednoznacznego znaczenia, na przykład przez dostępny tekst lub prawidłowo zastosowane aria-label.
Jeszcze gorsza sytuacja powstaje w rozbudowanych interfejsach React, Vue czy Angular, gdy div z obsługą kliknięcia udaje przycisk, menu rozwijane ma niewłaściwe role, a elementy formularza nie mają powiązanych etykiet. Strona wizualnie działa, tester myszką przechodzi cały proces, ale model interakcji dostępny dla maszyny jest niepełny.
Druga kontrola to CLS, czyli przesunięcia układu. Jeżeli agent najpierw lokalizuje przycisk na podstawie obrazu lub współrzędnych, a chwilę później nad nim pojawia się baner, reklama albo komunikat, pozycja celu może się zmienić. Efekt jest prosty: agent zamierza nacisnąć „Dalej”, a trafia w zupełnie inny element.
Na polskich stronach szczególnie trzeba sprawdzić:
banery zgód i platformy CMP ładowane po wyrenderowaniu strony;
reklamy oraz boksy bez zarezerwowanej wysokości;
obrazy bez ustalonych wymiarów;
webfonty powodujące zmianę szerokości lub wysokości tekstu;
paski promocyjne dokładane przez system marketing automation;
widgety czatu doklejane do DOM po kilku sekundach;
moduły rekomendacji produktów i sekcje personalizowane po stronie klienta.
Nie każdy agent korzysta ze współrzędnych — część pracuje na referencjach DOM lub accessibility tree. Dlatego dobry CLS nie gwarantuje, że automatyczna ścieżka zadziała. Jest jednak sensownym sygnałem stabilności interfejsu i wskazuje klasę błędów, która potrafi zerwać interakcję między rozpoznaniem elementu a wykonaniem akcji.
Najlepszy test nie kończy się zatem na zielonym wierszu Lighthouse. Po usunięciu problemów z accessibility tree trzeba ręcznie przejść kluczową ścieżkę z otwartym panelem Accessibility i sprawdzić, czy nazwy kontrolek odpowiadają temu, co widzi użytkownik. Przy aplikacjach dynamicznych warto zrobić to w kilku stanach: przed zaakceptowaniem cookies, po zgodzie, po otwarciu modala, po walidacji błędnego formularza i po załadowaniu treści asynchronicznej.
llms.txt i WebMCP: tutaj eksperymentalny charakter audytu widać najmocniej
llms.txt budzi najwięcej nieporozumień, bo nazwa sugeruje plik o podobnej wadze do robots.txt. Tak nie jest.
Lighthouse 13.4.1 próbuje pobrać /llms.txt z domeny. Zachowanie audytu jest bardzo konkretne:
odpowiedź 4xx, w tym 404, powoduje oznaczenie kontroli jako Not Applicable;
odpowiedź 5xx powoduje niezaliczenie audytu;
jeżeli plik zostanie poprawnie pobrany, Lighthouse sprawdza jego zawartość.
Walidacja zawartości jest przy tym zaskakująco prosta. Kod audytu sprawdza trzy warunki:
występuje przynajmniej jeden nagłówek Markdown H1, czyli linia zaczynająca się od
#;znajduje się przynajmniej jeden link w składni Markdown
[tekst](adres);zawartość ma minimum 50 znaków.
To nie jest pełny walidator specyfikacji llms.txt. Nie bada jakości streszczenia serwisu, sensowności wskazanych zasobów ani tego, czy jakikolwiek popularny agent faktycznie wykorzysta plik. Surowy adres URL bez składni Markdown może również nie spełnić technicznego testu linku.
Minimalny przykład przechodzący tę logikę może wyglądać tak:
# Sklep ABC

> Oficjalny serwis sklepu ABC z katalogiem produktów i obsługą klienta.

## Najważniejsze sekcje

- [Oferta](/oferta)
- [Kontakt](/kontakt)
Tu pojawia się irytująca właściwość obecnego audytu: brak llms.txt może skończyć się N/A, natomiast opublikowanie wadliwego pliku może dać błąd. Samo dodanie pliku „żeby Lighthouse był zielony” jest więc słabą strategią.
Jeszcze ważniejszy jest kontekst SEO. Google Search deklaruje, że llms.txt nie jest potrzebny do pojawiania się w wyszukiwarce ani w funkcjach generatywnej AI i nie pomaga ani nie szkodzi widoczności oraz rankingom Google Search. Jeżeli firma utrzymuje taki plik, powinna mieć inny powód: kompatybilność z konkretnymi systemami, własnym agentem, crawlerem albo eksperymentem technicznym. Nie SEO.
WebMCP idzie znacznie dalej. Zamiast pozostawiać agentowi zgadywanie, do czego służy formularz, strona może jawnie wystawić narzędzie opisujące akcję oraz jej parametry. W konfiguracji Lighthouse 13.4.1 znajdziemy trzy związane z tym kontrole: rejestrację narzędzi, pokrycie formularzy i poprawność schematu.
Deklaratywny formularz może mieć postać:
<form
  toolname="contact_request"
  tooldescription="Sends a request for contact">

  <label for="email">E-mail</label>
  <input
    id="email"
    name="email"
    type="email"
    required
    toolparamdescription="Email address for the reply">

  <button type="submit">Wyślij</button>
</form>
To przykład edukacyjny, nie gotowy wzorzec produkcyjny. Schemat narzędzia powinien odpowiadać faktycznym regułom aplikacji, a operacja nadal musi być sprawdzana przez backend.
Audyt poprawności WebMCP ma już konkretne warunki błędu. Lighthouse zgłasza problem m.in., gdy:
formularz ma
tooldescription, lecz nie matoolname;ma
toolname, lecz brakujetooldescription;wymagane pole formularza nie ma atrybutu
name.
Słabsze problemy mogą być raportowane jako ostrzeżenia, np. przy niepełnym opisie parametrów. To ważne rozróżnienie. Dobrze zbudowany schemat pomaga agentowi dobrać argumenty, ale nie potwierdza poprawności całego procesu biznesowego.
Do audytów WebMCP trzeba obecnie podchodzić jeszcze ostrożniej niż do accessibility tree. Dokumentacja określa technologię jako eksperymentalną i do wykonywania odpowiednich audytów wymaga udziału w WebMCP origin trial. Interfejs API oraz sposób jego wykorzystania przez agentów mogą się zmieniać.
Dlatego kolejność inwestycji powinna zależeć od produktu:
zwykła witryna treściowa lub lokalny serwis usługowy — najpierw semantyczny HTML, dostępność i stabilność; WebMCP można odłożyć;
sklep, system rezerwacyjny lub SaaS, w którym agent rzeczywiście ma wykonywać operacje — warto przygotować kontrolowany prototyp WebMCP;
proces z płatnością, zmianą umowy, danymi medycznymi, finansowymi albo inną operacją wysokiego ryzyka — nie wolno uznawać poprawnego audytu Lighthouse za zabezpieczenie procesu. Decyzje i uprawnienia muszą pozostać po stronie właściwej logiki aplikacji i użytkownika.
FAQ: Lighthouse Agentic Browsing w praktyce
Czy wynik Agentic Browsing wpływa na pozycję strony w Google?
Nie ma podstaw do traktowania go jako udokumentowanego czynnika rankingowego Google Search. To techniczny audyt interakcji maszynowej. Google dodatkowo informuje wprost, że llms.txt nie poprawia ani nie pogarsza widoczności oraz pozycji w Google Search.
Czy trzeba tworzyć llms.txt, żeby zaliczyć audyt?
Nie. W Lighthouse 13.4.1 odpowiedź 4xx dla /llms.txt, w tym brak pliku zwracający 404, prowadzi do statusu N/A. Jeżeli jednak plik istnieje, jego zawartość jest walidowana.
Co Lighthouse sprawdza w llms.txt?
W wersji 13.4.1 sprawdza co najmniej nagłówek H1, link w składni Markdown i długość minimum 50 znaków. Jest to podstawowy test techniczny, a nie pełna ocena jakości pliku.
Czy Agentic Browsing testuje prawdziwego agenta AI wykonującego zadanie?
Nie. Audyty wykorzystują deterministyczne sygnały techniczne. Wynik nie zastępuje testu end-to-end z agentem wykonującym konkretną ścieżkę użytkownika.
Czy WebMCP trzeba wdrażać już teraz?
Nie na każdej stronie. Technologia pozostaje eksperymentalna. Ma więcej sensu w aplikacjach, sklepach i systemach transakcyjnych, w których agent ma wykonywać precyzyjnie zdefiniowane działania. Na stronie informacyjnej zwykle większy zwrot da naprawa semantyki HTML i dostępności.
Dlaczego wyniki mogą zmieniać się między uruchomieniami?
Powodem może być dynamiczny DOM, różny moment rejestracji narzędzi WebMCP, treści doładowywane przez JavaScript albo przesunięcia layoutu. Dlatego w aplikacji dynamicznej pojedynczy raport nie powinien być jedyną podstawą decyzji.
Od czego zacząć poprawianie strony?
Najpierw usuń błędy accessibility tree: brakujące nazwy przycisków i linków, nieopisane pola oraz błędne role ARIA. Następnie wyeliminuj przesunięcia interfejsu, które utrudniają stabilną interakcję. llms.txt naprawiaj wtedy, gdy świadomie go publikujesz, a WebMCP wdrażaj dopiero wtedy, gdy masz konkretną funkcję, którą agent rzeczywiście powinien wykonywać. To jest właściwa kolejność — zaczynanie od pliku llms.txt tylko po to, by poprawić raport, rozwiązuje najmniej istotny problem.
Przejdź do części artykułu
Opublikowane w kategorii: Techniczne SEO dla AI