„Kto, jak i dlaczego” jako architektura artykułu, a nie tylko checklista E-E-A-T
Najczęstszy błąd przy wdrażaniu E-E-A-T nie polega na braku bio autora czy daty aktualizacji. Problem zaczyna się wcześniej: redakcja traktuje wiarygodność jak zestaw elementów do doklejenia po napisaniu tekstu. Autor jest, źródła są, data jest, schema została wdrożona — formalnie wszystko się zgadza. Tylko czytelnik nadal nie wie, kto właściwie odpowiada za materiał, jak powstały zawarte w nim ustalenia i dlaczego ten tekst istnieje.
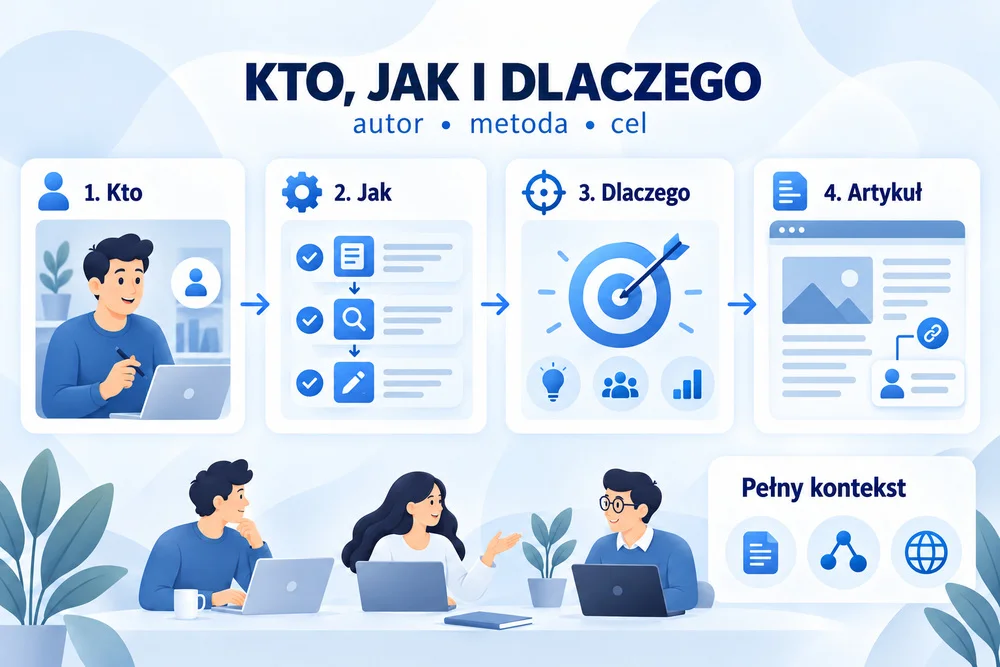
Oficjalne zalecenia Google porządkują ten problem trzema pytaniami: Who, How, Why — Kto, jak i dlaczego. I właśnie jako architektura publikacji są one znacznie bardziej użyteczne niż jako kolejna checklista SEO.
To rozróżnienie jest istotne również dlatego, że E-E-A-T nie jest pojedynczym czynnikiem rankingowym. Google opisuje doświadczenie, wiedzę, autorytet i zaufanie jako zestaw cech pomagających oceniać jakość treści, przy czym najważniejszym elementem pozostaje zaufanie. „Kto, jak i dlaczego” daje redakcji prostszą odpowiedź na pytanie, gdzie to zaufanie ma być widoczne na konkretnej stronie.
„Kto” nie oznacza pola z imieniem. Oznacza odpowiedzialność za treść
Podpis „Jan Kowalski” pod tytułem niewiele daje, jeżeli nazwisko prowadzi donikąd, a użytkownik nie jest w stanie ustalić, dlaczego właśnie tej osobie miałby zaufać. Google wprost zachęca do podawania dokładnych informacji o autorach tam, gdzie czytelnik naturalnie się ich spodziewa, oraz do prowadzenia z podpisu do szerszej informacji o twórcy i zakresie jego kompetencji.
Dobrze zaprojektowany moduł „Kto” powinien odpowiadać co najmniej na cztery pytania:
kto napisał materiał,
jaka jest rola tej osoby w publikacji,
z czego wynika jej kompetencja do opisania tematu,
kto odpowiadał za dodatkową weryfikację, jeżeli była potrzebna.
Nie każdy artykuł wymaga profesora, radcy prawnego czy lekarza jako autora. To częsty błąd interpretacyjny. W tekście o użytkowaniu ekspresu do kawy cenne może być udokumentowane doświadczenie osoby, która rzeczywiście porównała urządzenia. Przy materiale dotyczącym interpretacji przepisów podatkowych sam fakt używania programu księgowego już nie wystarcza. Rodzaj kompetencji musi odpowiadać ryzyku wynikającemu z tematu.
Dlatego tekst o wyborze butów trekkingowych może być podpisany przez testera sprzętu, ale tekst opisujący przeciwwskazania medyczne powinien mieć mocniejszą podstawę ekspercką. W tematach YMYL — dotyczących m.in. zdrowia, finansów i bezpieczeństwa — próg zaufania jest po prostu wyższy.
W praktyce moduł autora powinien zawierać krótki opis specjalizacji, a nie reklamową biografię w rodzaju „pasjonat nowych technologii z wieloletnim doświadczeniem”. Lepsza jest informacja: „od 2019 r. testuje oprogramowanie księgowe dla mikrofirm” albo „radca prawny zajmujący się prawem pracy”. Czytelnik dostaje wtedy konkretną przesłankę do oceny autora.
Trzeba również rozdzielić autora, redaktora i eksperta weryfikującego. Jeżeli dziennikarz przygotował tekst na podstawie dokumentacji, a prawnik sprawdził fragment dotyczący prawa, podpisanie całości wyłącznie nazwiskiem prawnika zaciera faktyczny proces. Wiarygodność nie rośnie od przypisywania ekspertowi większej roli, niż rzeczywiście odegrał.
Technicznie dane autora można uzupełnić w uporządkowanych danych Article. Google obsługuje m.in. author, author.name i author.url, a przy kilku autorach zaleca oznaczenie każdego z nich osobno. To jednak warstwa pomocnicza, nie zamiennik widocznego podpisu i profilu autora.
Przykładowy zapis edukacyjny może wyglądać tak:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Przykładowy tytuł artykułu",
  "datePublished": "2026-09-20T09:00:00+02:00",
  "dateModified": "2026-09-25T12:30:00+02:00",
  "author": {
    "@type": "Person",
    "name": "Anna Kowalska",
    "jobTitle": "Redaktorka",
    "url": "/autor/anna-kowalska"
  }
}
Najgorszy wariant? Wymyślony autor, stockowe zdjęcie i profil składający się z dwóch ogólnych zdań. Taki moduł nie wyjaśnia „kto”. Jedynie imituje odpowiedź.
„Jak” powinno pokazywać warsztat, a nie zasłaniać go słowem „redakcja”
To najbardziej niedoceniony fragment całej konstrukcji. Google wskazuje, że użytkownikowi może pomagać informacja o sposobie powstania treści, a zalecenie obejmuje również materiały automatyczne, generowane przez AI i wspomagane przez AI.
Nie oznacza to obowiązku doklejania do każdego tekstu etykiety „stworzono z użyciem sztucznej inteligencji”. Sens jest inny: jeżeli sposób przygotowania materiału ma znaczenie dla jego wiarygodności, powinien być opisany na tyle konkretnie, aby odbiorca rozumiał, skąd wzięły się informacje.
W recenzji sprzętu sekcja „Jak powstał materiał” może podawać:
liczbę testowanych urządzeń,
czas testu,
warunki pomiaru,
zastosowane narzędzia,
kryteria porównania,
elementy, których nie udało się sprawdzić.
W poradniku prawnym będzie wyglądała inaczej: podstawa prawna, wersja aktu, data sprawdzenia, ewentualna weryfikacja przez prawnika. W analizie cenowej liczą się zakres danych, okres obserwacji, sposób liczenia mediany lub średniej i informacja, czy ceny były ofertowe, czy transakcyjne.
Przy AI-assisted content sensowna nota nie powinna brzmieć: „Tekst powstał przy użyciu nowoczesnych narzędzi AI”. To niczego nie wyjaśnia.
Lepszy zapis to na przykład:
Materiał opracowano na podstawie dokumentacji producenta i obowiązujących wytycznych. Narzędzia AI wykorzystano do uporządkowania materiału i wsparcia redakcji. Dobór źródeł, interpretacja informacji i końcowa wersja tekstu należą do autora.
Różnica jest zasadnicza. Pierwsza wersja informuje o narzędziu. Druga opisuje proces i podział odpowiedzialności.
To szczególnie ważne teraz, gdy samo używanie generatywnej AI nie jest przez Google traktowane jako automatyczne naruszenie. Problemem jest przede wszystkim sposób wykorzystania automatyzacji. Generowanie dużej liczby stron bez dodatkowej wartości dla użytkownika może wejść w obszar scaled content abuse, czyli nadużywania treści na dużą skalę.
Granica nie przebiega więc między „człowiek” i „AI”. Przebiega między materiałem, do którego ktoś wniósł pracę redakcyjną, ocenę i wartość, a produkcją stron nastawioną przede wszystkim na skalę i manipulowanie widocznością.
Z punktu widzenia redakcji oznacza to jeszcze jedną zmianę: noty metodologicznej nie warto generować automatycznie z jednego szablonu. Jeżeli pod każdym tekstem pojawia się identyczne „artykuł przygotowano na podstawie rzetelnych źródeł”, sekcja przestaje przekazywać informację.
Powinna odpowiadać na faktyczny proces dla danego materiału. Jeżeli AI jedynie poprawiła język, napisz to. Jeżeli przygotowała pierwszą wersję na podstawie wskazanych źródeł — również. Jeżeli człowiek sprawdził jedynie część danych, nie sugeruj pełnej eksperckiej weryfikacji.
Tu właśnie najłatwiej zepsuć cały model „Kto, jak i dlaczego”: stworzyć efektowną deklarację przejrzystości, która sama jest nieprecyzyjna.
„Dlaczego” decyduje, czy artykuł ma własny powód istnienia
Google nazywa „dlaczego” prawdopodobnie najważniejszym z trzech pytań. To logiczne. Można mieć prawdziwego autora i perfekcyjnie opisany proces, a mimo to produkować tekst, którego jedynym uzasadnieniem jest przejęcie ruchu na kolejną frazę.
„Dlaczego” nie powinno być tekstem publikowanym w formie deklaracji. Powinno sterować konstrukcją artykułu.
Jeżeli celem materiału jest pomóc użytkownikowi wybrać pompę ciepła do domu o powierzchni 150 m², tekst musi prowadzić do decyzji: jak policzyć zapotrzebowanie, jakie parametry odrzucić, gdzie potrzebne są dane z projektu i kiedy internetowy poradnik przestaje wystarczać.
Jeżeli celem jest wyjaśnienie zmiany podatkowej, materiał powinien odpowiedzieć: kogo zmiana obejmuje, od kiedy, jakie są wyjątki, co trzeba zrobić i jaki dokument sprawdzić. Kolejna definicja podatku, napisana tylko dlatego, że fraza ma duży wolumen wyszukiwania, nie rozwiązuje problemu użytkownika.
To dobry moment na prosty test redakcyjny. Przed zamówieniem tekstu trzeba uzupełnić jedno zdanie:
„Po przeczytaniu tego materiału odbiorca będzie potrafił…”
Jeżeli odpowiedź brzmi „lepiej zrozumie temat”, brief jest za słaby. Potrzebny jest rezultat operacyjny: porównać dwie opcje, policzyć koszt, przygotować dokumenty, odrzucić niepasujący produkt, rozpoznać ryzyko, wybrać właściwą procedurę.
Dopiero później ma sens analiza fraz kluczowych.
To odwraca popularną kolejność pracy:
najpierw problem użytkownika i decyzja, którą ma podjąć,
następnie zakres informacji potrzebnych do tej decyzji,
dalej źródła, autor i metoda przygotowania,
dopiero potem optymalizacja języka, nagłówków i zapytań wyszukiwania.
SEO nadal jest potrzebne. Google samo rozróżnia treści przygotowane z myślą o ludziach od działań technicznych pomagających wyszukiwarce znaleźć i zrozumieć stronę. Błąd zaczyna się wtedy, gdy kolejność zostaje odwrócona i zapytanie z narzędzia SEO staje się jedynym powodem stworzenia artykułu.
W praktyce „Kto, jak i dlaczego” powinno znaleźć się w szablonie publikacji jeszcze przed polem „tekst główny”. Dobry model CMS może wymagać od redaktora uzupełnienia:
autora i jego roli,
osoby odpowiedzialnej za weryfikację, jeśli występuje,
sposobu przygotowania materiału,
głównych źródeł,
daty weryfikacji informacji zmiennych,
roli AI lub automatyzacji,
celu użytkownika, któremu materiał ma służyć.
Nie wszystkie te dane trzeba pokazywać dokładnie w tym samym miejscu. Autor może mieć osobny profil. Źródła mogą trafić do dedykowanej sekcji. Metodologia może znaleźć się pod artykułem. Cel publikacji powinien być natomiast widoczny przede wszystkim w samej treści — w tym, jakie problemy rozwiązuje i jak prowadzi odbiorcę do decyzji.
Największe ograniczenie tej koncepcji jest proste: sam szablon niczego nie gwarantuje. Można technicznie uzupełnić każde pole i nadal opublikować słaby materiał. Google nie podaje też punktacji typu „autor +2, źródła +3, disclosure AI +1”. Taki kalkulator E-E-A-T nie istnieje.
„Kto, jak i dlaczego” działa wtedy, gdy wymusza lepsze decyzje redakcyjne, a nie gdy staje się formularzem do mechanicznego odhaczenia.
FAQ: „Kto, jak i dlaczego” w praktyce
Czy E-E-A-T jest czynnikiem rankingowym Google?
Nie jako pojedynczy, mierzalny czynnik. Google wyjaśnia, że jego systemy korzystają z wielu sygnałów, które mogą odpowiadać cechom doświadczenia, wiedzy, autorytetu i zaufania. Samo „E-E-A-T” nie jest pojedynczą wartością, którą można zwiększyć o określoną liczbę punktów.
Czy każdy artykuł powinien mieć podpis autora?
Tam, gdzie użytkownik naturalnie oczekuje informacji o autorstwie, Google zdecydowanie zaleca dokładne dane autora. W praktyce dotyczy to szczególnie artykułów eksperckich, poradników, analiz, recenzji i treści YMYL. Anonimowość nie jest automatycznie zakazana, ale utrudnia użytkownikowi ocenę odpowiedzialności za materiał.
Czy trzeba oznaczać każdy tekst przygotowany z pomocą AI?
Google nie formułuje uniwersalnego obowiązku etykietowania każdego użycia AI. Wskazuje natomiast, że ujawnienie sposobu przygotowania materiału jest użyteczne tam, gdzie odbiorca może zasadnie pytać „jak to powstało?”. Przy znaczącym udziale automatyzacji warto jasno opisać jej rolę i zakres ludzkiej kontroli.
Czy treści generowane przez AI są zakazane?
Nie. Problemem jest m.in. masowe generowanie stron bez dodatkowej wartości dla użytkownika i wykorzystywanie automatyzacji przede wszystkim do manipulowania rankingami. Liczy się jakość, trafność, dokładność i faktyczna wartość materiału.
Czy schema Article wystarczy do pokazania autorstwa?
Nie. Dane strukturalne pomagają wyszukiwarce zrozumieć stronę, ale nie zastępują informacji widocznych dla odbiorcy. Autor powinien być czytelnie oznaczony również w interfejsie strony.
Czy sekcja „Jak powstał ten materiał” poprawi ranking?
Nie ma podstaw, by obiecywać bezpośredni wzrost pozycji po dodaniu takiej sekcji. Jej wartość polega na zwiększeniu przejrzystości i umożliwieniu odbiorcy oceny procesu przygotowania treści. To element jakości publikacji, a nie techniczny trik SEO.
Pierwsza zmiana, którą warto wprowadzić, nie dotyczy schema ani generatora bio autorów. Weź pięć ostatnio opublikowanych artykułów i sprawdź, czy dla każdego da się jednoznacznie odpowiedzieć: kto odpowiada za treść, jak zweryfikowano informacje i jaką konkretną decyzję użytkownik ma podjąć po lekturze. Jeśli którejś odpowiedzi brakuje, napraw najpierw proces redakcyjny. Dopiero potem automatyzuj pola w CMS.
Przejdź do części artykułu
Opublikowane w kategorii: Strategia i planowanie treści